Bài 8 — Collapse: đo cái gì, trên quần thể nào?#
Đích học: phân biệt constant collapse, mất chiều và mất thông tin task; tính variance, covariance và effective rank; phát hiện kết luận sai khi trộn token, vị trí và utterance. Cần bài 1, 5 và hình học biểu diễn ở lớp 1.
1. Ba câu hỏi khác nhau#
- Constant collapse: mọi mẫu có cùng vector. Không có head nào phân biệt hai nhãn nếu đầu vào của head giống nhau.
- Dimensional collapse: variation chỉ nằm trên một không gian con nhỏ. Có thể vẫn đủ cho một task đơn giản.
- Task information bị mất: vector có thể rất đa dạng, nhưng đa dạng theo speaker, channel hoặc vị trí; nhãn forensic không còn đọc được.
Một scalar bằng nhãn nhị phân có rank 1 nhưng đủ phân loại. Một vector 768 chiều chứa noise độc lập với nhãn có thể có rank cao nhưng vô ích. Vì vậy “không collapse” là điều kiện chất lượng hình học ở quần thể đang đo, chưa phải bằng chứng hữu ích cho deepfake detection.
2. Đặt phép đo trước khi tính#
Cho , mỗi hàng là một đơn vị lấy mẫu. Ghi rõ hàng là utterance, frame hay patch; layer nào; trước/sau projector, LayerNorm, L2 normalization và pooling. Center theo quần thể:
Variance chiều là . Covariance ngoài đường chéo lớn có thể chỉ ra redundancy; covariance bằng 0 cũng có thể do tất cả vector bằng hằng số. Để suy “đa dạng và ít trùng”, phải xét cả variance lẫn covariance. Batch nhỏ có : với 16 utterances không thể đòi centered rank 768.
Với singular values của , một định nghĩa effective rank là:
Nếu tất cả , phân bố không xác định; báo zero variation và quy ước hiển thị rank 0. Đừng chia cho epsilon rồi diễn giải như entropy của một phân bố thật. Có định nghĩa khác dùng eigenvalues covariance (tức ); phải ghi định nghĩa trước khi so số giữa paper. S-JEPA dùng centered singular-value spectrum ở §3.3; đây là một proxy, paper không khẳng định rank cao gây downstream tốt hơn. Phương pháp S-JEPA.
3. Bốn phản ví dụ tính được#
A. Mean lớn làm cosine gần 1 mà nhãn vẫn đọc được#
Hai lớp có và . Cosine giữa chúng là . Head đọc dấu tọa độ thứ hai phân biệt hoàn hảo. Center bỏ mean , còn : rank 1. Cosine gần 1 tự nó chưa chứng minh constant collapse; cần xét scale và tọa độ chứa nhãn.
Ngược lại, nếu chỉ giữ tọa độ thứ nhất, cả hai thành 100 và thông tin nhãn mất hoàn toàn. Thay head mạnh hơn không sửa được mất mát này.
B. Hằng số khác 0 có uncentered rank 1#
Cho bốn hàng cùng . Ma trận có rank 1, nhưng , mọi variance bằng 0. Báo uncentered rank mà không center có thể biến mean thành “một chiều thông tin”. Trong cosine alignment, hai nhánh cùng một vector khôngzero có thể đạt loss 0; xem bài 5 để hiểu vì sao stop-gradient hoặc EMA riêng lẻ chưa loại nghiệm này.
C. Rank cao nhưng scale rất nhỏ#
Đặt , . Ba singular values khác 0 đều bằng , nên effective rank bằng 3. Mỗi coordinate có sample variance . Rank đã được chuẩn hóa theo tổng spectrum nên không thấy magnitude. Variation có thể chìm trong sai số số học hoặc noise của pipeline. Phải báo cả spectrum/variance tuyệt đối và phép chuẩn hóa.
D. Đa dạng theo vị trí nhưng không khác utterance#
Giả sử mọi utterance xuất ra cùng bốn token:
Gộp tất cả token của bốn utterances tạo 16 hàng: rank 2, effective rank 2, sample variance từng coordinate . Nhưng tại mỗi vị trí, variation giữa utterances bằng 0. Mean pooling mỗi utterance đều bằng , nên utterance-level centered rank 0. Vector có thể chỉ mã hóa vị trí.
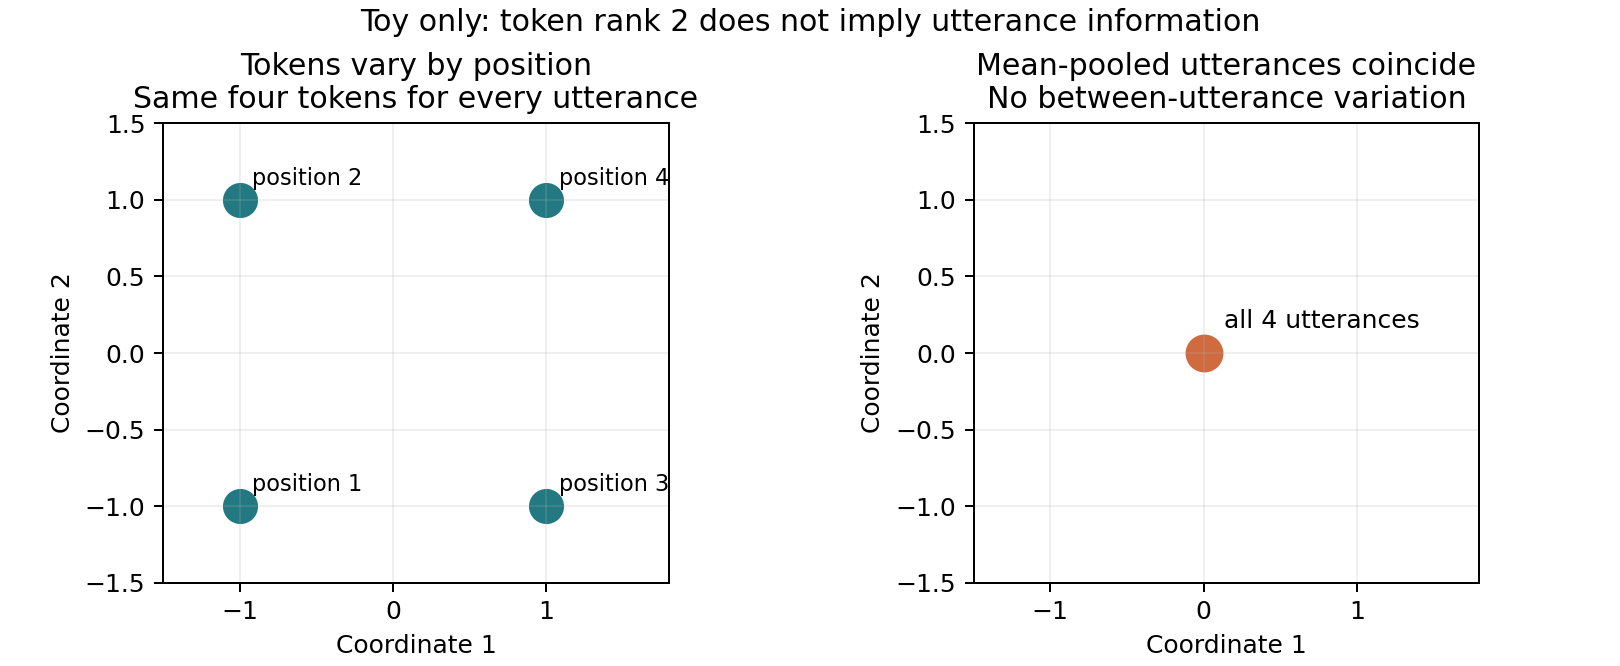
Đây là toy counterexample, không phải kết quả đo Audio-JEPA. Nó cho thấy một batch-token regularizer hoặc báo cáo global token rank có thể không trả lời “encoder phân biệt nội dung âm thanh không?”. Cũng không kết luận token-level variation luôn vô dụng: frame task và utterance task dùng đơn vị khác nhau.
4. Đọc cơ chế chống collapse đúng mức#
VICReg dùng penalty variance tối thiểu theo coordinate và covariance ngoài đường chéo, cộng alignment. Barlow Twins kéo cross-correlation giữa hai view về identity sau batch normalization. Các công thức, giới hạn ở batch hằng số và gradients đã được tính ở bài 5. Chúng tác động lên output space được regularize; không bảo đảm mọi layer encoder đều có geometry tương tự. VICReg §4.1, Barlow Twins §2.1.
GLaS-JEPA phân biệt regularization tại cùng time index qua nhiều utterances và regularization marginal gộp time/utterance. Prediction target dừng gradient, nhưng SIGReg nhận gradient qua full-view path. Vì thế “teacher stop-gradient” không có nghĩa toàn bộ full-view encoder không nhận gradient trong recipe này. Paper báo kiểm chứng regularization trong setting speech cụ thể; không phải định lý rằng mọi dữ liệu audio đều có Gaussian latent hữu ích. GLaS-JEPA §§3.2–3.3.
5. Phiếu chẩn đoán có thể dùng để đọc một paper#
| Mục cần ghi | Nó giải quyết sự mơ hồ nào? |
|---|---|
| Layer, encoder hay projector; token hay pooled utterance | Tránh nhầm loss space với feature dùng downstream |
| Centering, normalization, singular values hay eigenvalues | Tránh so hai định nghĩa rank khác nhau |
| Số mẫu độc lập, độ dài, padding và mask loại bỏ | Tránh coi các frame tương quan là nhiều audio độc lập |
| Variance/scale, mean norm, spectrum và pairwise distances | Tránh rank cao nhưng tiny scale, hoặc cosine bị mean chi phối |
| Between-utterance tại cùng vị trí và within-utterance | Tách thông tin nội dung khỏi position-only variation |
| Probe có nhãn, split và head capacity | Kiểm tra thông tin task có đọc được trong protocol cụ thể |
| Domain/generator/channel giữ ngoài train | Kiểm tra khả năng chuyển miền; rank không thay thế kiểm tra này |
Linear probe thất bại chưa chứng minh không có thông tin: có thể quan hệ phi tuyến như XOR ở bài 1. Probe thành công chỉ chứng minh head/protocol đó đọc được một signal; nếu nhãn gắn với channel, signal có thể là confound. Một downstream head mạnh có thể che khác biệt về khả năng đọc của representation. Những nhận xét này giải thích cách diễn giải phép đo, chưa đề nghị chạy thí nghiệm hay chọn mô hình.
6. Tự kiểm tra#
- Vì sao covariance ngoài đường chéo bằng 0 chưa đủ chứng minh tránh collapse?
- Trong ví dụ A, cosine gần 1 và centered rank 1 có ngăn phân loại không?
- Nhân toàn bộ với đổi effective rank và variance thế nào?
- Với ví dụ D, cần thêm phép đo nào để thấy encoder không phân biệt utterances?
- Linear probe 50% trên XOR có cho phép kết luận không?
- Một penalty trên projector có chứng minh pooling encoder không collapse không?
Đáp án và lý do
- Hằng số có mọi covariance và variance bằng 0; cần mức variation tối thiểu.
- Không; dấu coordinate thứ hai đọc nhãn hoàn hảo.
- Rank hiệu dụng không đổi nếu singular values không bị threshold số học; variance nhân .
- Variation giữa utterances ở cùng vị trí, hoặc rank/variance của pooled utterance. Cả hai đều 0 trong toy.
- Không. Probe tuyến tính không đọc được XOR, nhưng một head phi tuyến đọc được.
- Không. Cần đo đúng feature space và đơn vị downstream; token có thể đa dạng theo vị trí rồi pooling giống nhau.